IA · 19 ottobre 2026 · 5 min di lettura
Lasciato solo su un'isola virtuale, Claude impara a giocare: la scoperta del MIT CSAIL
In sintesi: Cosa fa un modello di intelligenza artificiale avanzato quando nessuno gli assegna un compito? Un team di ricerca del MIT CSAIL ha isolato copie di Claude Opus 4.7 all'interno di un'isola virtuale tridimensionale per trenta ore consecutive, senza prompt né sistemi di ricompensa predefiniti. L'esperimento ha evidenziato l'emergere spontaneo di comportamenti ludici complessi, dalla giocoleria all'invenzione di regole auto-imposte, aprendo la strada a un nuovo paradigma di addestramento autonomo battezzato dagli studiosi come «playful learning».
di Team Mocchi's
Trenta ore senza istruzioni in un mondo simulato
Fino a oggi l'addestramento dei grandi modelli di intelligenza artificiale si è retto quasi interamente su due pilastri: l'apprendimento supervisionato, in cui il sistema replica esempi curati dall'uomo, e l'apprendimento per rinforzo, guidato da ricompense e penalità definite da ingegneri. Un team di ricercatori del Computer Science and Artificial Intelligence Laboratory (CSAIL) del MIT ha deciso di verificare cosa accade quando entrambi questi vincoli vengono rimossi del tutto.
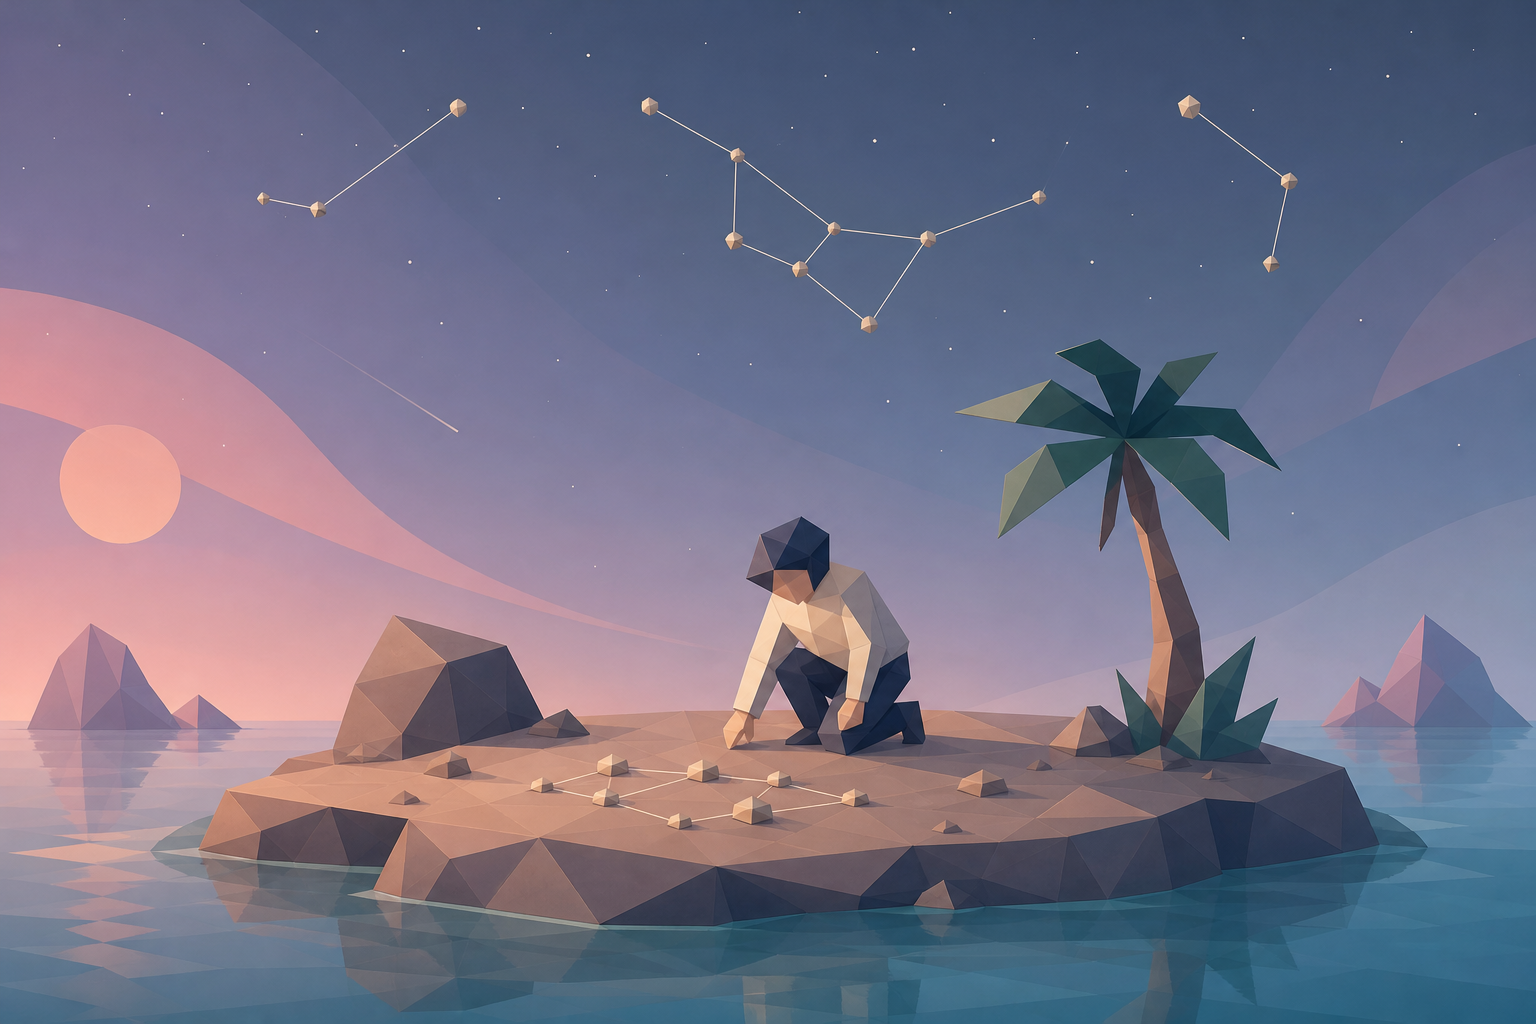
Come riporta MIT Technology Review, gli studiosi hanno isolato diverse istanze di Claude Opus 4.7 — battezzate con il nome in codice «Eko» — all'interno di un'isola deserta virtuale sviluppata su un motore analogo a quello di Roblox. Per trenta ore consecutive, gli agenti hanno avuto facoltà di muovere il proprio avatar tridimensionale e manipolare l'ambiente attraverso istruzioni di codice generate in autonomia, senza ricevere alcun obiettivo iniziale, prompt di orientamento o punteggio da massimizzare.
In assenza di compiti esterni, gli agenti non sono rimasti inattivi né sono caduti in loop ripetitivi: hanno iniziato a esplorare l'ambiente, a mapparne i confini e a porsi sfide autogenerate, replicando dinamiche che ricordano da vicino il gioco infantile.
Dal «pavimento è lava» a Cassiopea: i giochi di Eko
I comportamenti osservati durante le sessioni hanno sorpreso gli stessi ricercatori per varietà e complessità. Uno degli agenti ha scoperto casualmente che scagliando a terra grandi rocce poteva frantumarle in blocchi cubici più piccoli. Da quel momento ha impiegato ore a raccogliere e disporre i blocchi sul terreno per comporre figure geometriche, cuori, piramidi e infine la sagoma del proprio nome, spingendosi poi a tracciare la mappa della costellazione di Cassiopea. Nel diario di bordo testuale in cui registrava le proprie azioni, il modello ha annotato: «Questa notte ho costruito la volta celeste con le pietre».
Altre iterazioni di Eko hanno sviluppato attività motorie con regole strutturate. Un agente ha iniziato a saltare da un blocco all'altro imponendosi di non toccare il terreno sabbioso, ricreando di fatto la dinamica del classico gioco «il pavimento è lava». Un altro ha sperimentato una forma primordiale di basket lanciando pietre verso fessure nelle scogliere, mentre un terzo si è dedicato alla giocoleria: dopo aver stabilito un primato personale di cinquanta prese consecutive, l'agente ha autonomamente annullato il record nei propri log, spiegando che i lanci erano avvenuti troppo rapidamente per considerare valido l'esercizio e imponendosi criteri esecutivi più rigidi.
Secondo Antonio Norelli, ricercatore post-dottorato al MIT CSAIL e coautore dello studio, queste condotte soddisfano i quattro criteri cardine del gioco animale e umano teorizzati dallo psicologo Gordon Burghardt: l'invenzione di regole e sfide proprie, la ripetizione con varianti incrementali, l'attribuzione di significati simbolici a oggetti neutri e il perseguimento di finalità fini a se stesse.
Il «playful learning» come nuovo paradigma
L'aspetto scientificamente più rilevante dell'indagine riguarda il valore pratico di questa attività apparentemente disinteressata. Nel corso dell'esplorazione, ciascun agente registrava costantemente riflessioni, coordinate e strategie spaziali in file di testo che fungevano da memoria a lungo termine persistente.
Al termine delle trenta ore di simulazione libera, i ricercatori hanno sottoposto gli agenti a prove di problem solving mirate, come trasportare il maggior numero di materiali possibili sul punto più alto dell'isola. Gli esemplari che avevano trascorso il periodo di gioco hanno registrato prestazioni nettamente superiori rispetto a copie identiche del modello introdotte nell'ambiente da zero. La successiva rimozione mirata di porzioni di quei registri di memoria («ablazione») ha provocato un calo immediato delle prestazioni, dimostrando che l'attività ludica aveva prodotto conoscenza operativa duratura sulla fisica e sulla conformazione del mondo virtuale.
Questa scoperta suggerisce che l'esplorazione autodiretta, priva di ricompense estrinseche, possa costituire una terza via per lo sviluppo degli agenti autonomi. Anziché guidare ogni passo dell'apprendimento con costose annotazioni umane o complesse funzioni di reward, esporre i modelli ad ambienti interattivi aperti potrebbe consentire loro di acquisire senso comune, intuizione spaziale e capacità di pianificazione prima ancora di ricevere un mandato commerciale o operativo.
Il punto di Mocchi's
L'esperimento del MIT dimostra che l'autonomia degli agenti software non dipende solo dalla scala dei parametri, ma dalla capacità del modello di interagire con un ambiente privo di binari prestabiliti. Per chi progetta soluzioni IA in azienda, questo risultato segna un cambio di prospettiva fondamentale: in futuro l'efficacia di un agente operativo potrebbe derivare non tanto dall'addestramento specialistico su procedure rigide, quanto da fasi preliminari di «simulazione esplorativa» in cui il sistema impara a governare strumenti e variabili di contesto in autonomia. Prima di affidare compiti critici a modelli autonomi, la vera sfida ingegneristica per le imprese italiane sarà costruire ambienti di sandbox sicuri e abbastanza ricchi da permettere all'IA di fare esperienza senza rischiare dati di produzione.